Web
Internet est le réseau. Le Web est une application qui tourne dessus : des pages, des liens, des images, que le navigateur va chercher sur des serveurs. On va voir comment cette application est née, puis ce qui se passe vraiment quand une adresse est tapée.
Comment le Web est arrivé
En 1989, Tim Berners-Lee et Robert Cailliau travaillent au CERN, en Suisse. Leur problème est concret : les chercheurs ont des documents éparpillés sur des machines différentes, et personne ne sait plus où chercher. Ils proposent de relier ces documents par des hyperliens, des liens cliquables qui mènent d'une ressource à une autre, même si elle est stockée ailleurs dans le monde.
En 1991, la première page est mise en ligne au CERN. Elle explique le projet, et comment s'en servir. En 1993, le CERN décide que le Web sera libre, sans redevance. Cette décision compte autant que l'invention elle-même : n'importe qui peut publier, sans payer une licence aux inventeurs. C'est ce qui permet l'explosion qui suit. Aujourd'hui, on compte plus de 1,7 milliard de sites.
Au début, le Web se lit. Entre 1990 et 2000 environ, une page ressemble à un journal : on arrive, on lit, on repart. On appelle parfois cela le Web 1.0. À partir des années 2000, chacun publie aussi. Un commentaire, une photo, un article de wiki : c'est le Web participatif, souvent appelé Web 2.0. Les réseaux sociaux, les blogs et les wikis en sont les formes les plus visibles.
Dans les années 1990, deux navigateurs se disputent le marché, Netscape et Internet Explorer. Microsoft gagne cette première bataille. Plus tard, Chrome prendra la place. Le navigateur n'est pas le Web : c'est le programme qui l'affiche. Mais celui qui domine le marché influence beaucoup ce que les sites ont le droit de faire.
Un hyperlien est un lien cliquable vers une ressource, parfois sur un autre serveur. C'est l'idée centrale du Web : le document ne s'arrête pas à la page affichée.
Voici un lien vers l'accueil du site : accueil. Pour voir à quoi ressemblait le tout début, la première page du CERN est encore en ligne.
Qui demande, qui répond
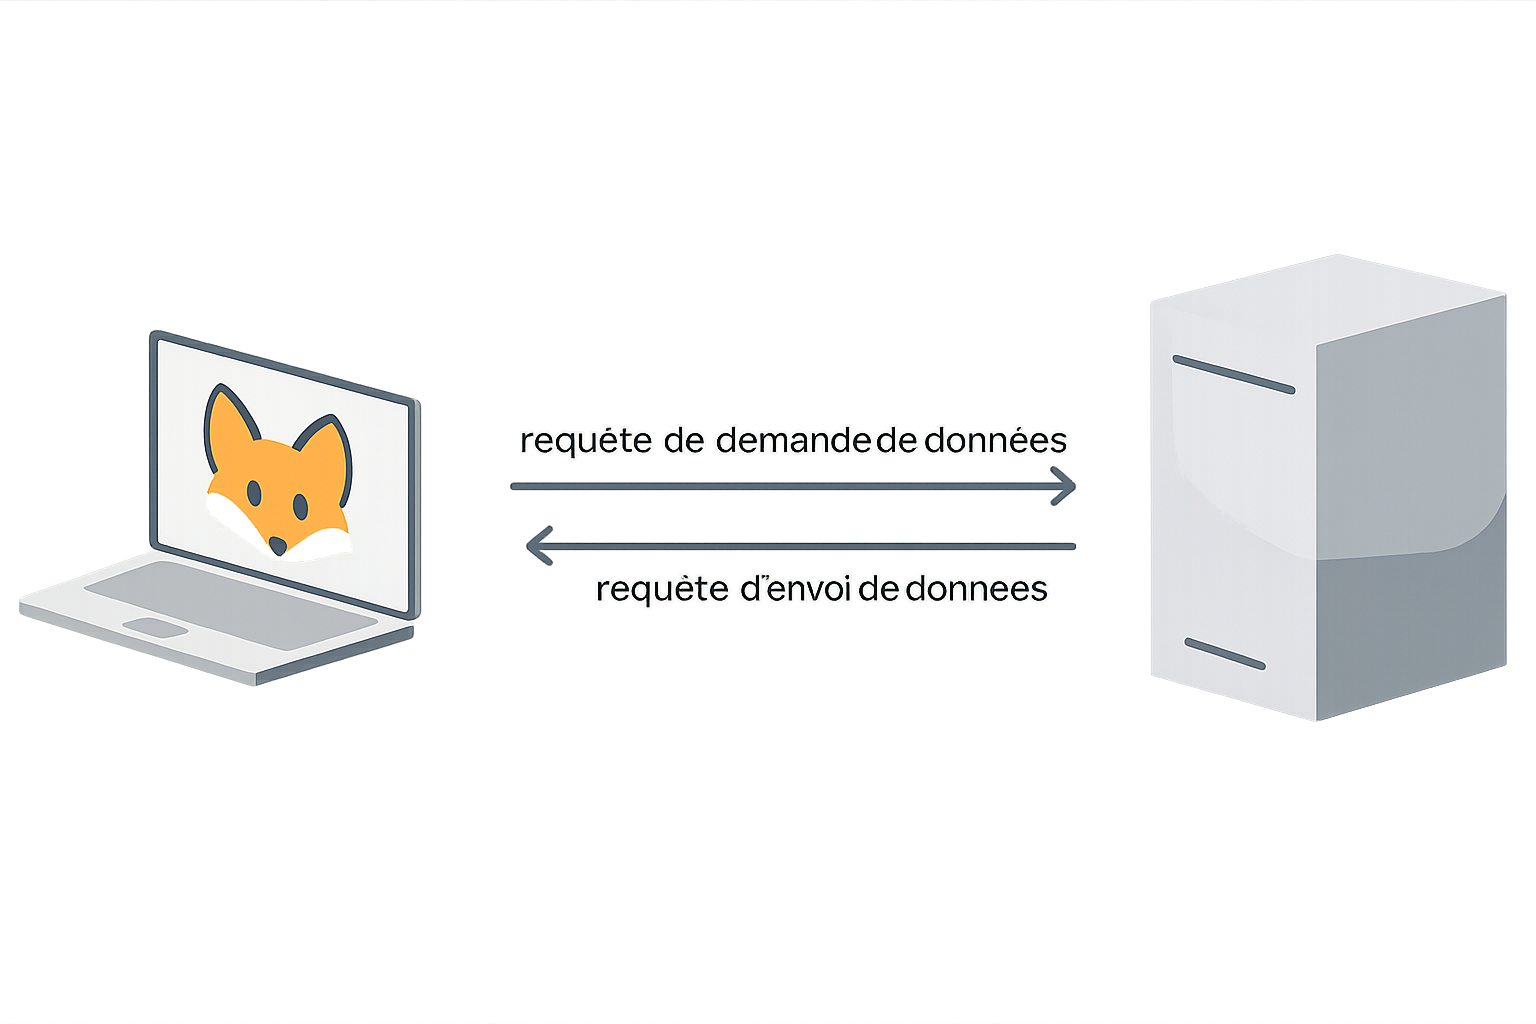
Le Web fonctionne en client-serveur. Les deux machines n'ont pas le même rôle, et ce rôle peut changer d'une requête à l'autre.
Le client est la machine qui veut recevoir quelque chose. Dans la vie courante, c'est le navigateur. Du point de vue de TCP, c'est la machine réceptrice. Le serveur détient la page, l'image ou la vidéo, et l'envoie. C'est l'émettrice.
Ils ne s'envoient pas des phrases libres. Ils échangent des requêtes, des messages dont la forme est fixée à l'avance : on demande une ressource, ou on en envoie une, et l'autre côté sait comment lire la demande.
De l'adresse IP à l'adresse tapée
Personne ne retient 216.58.214.163 pour ouvrir Google. On retient une URL, Uniform Resource Locator : une adresse écrite pour les humains.
Laboratoire du renard
Constructeur d'URL
Assemble chaque partie d'une adresse web.
Le DNS (Domain Name System) tient la table de correspondance entre ces noms et les adresses IP. Quand un nom est demandé, quelqu'un doit le traduire.
| Site | Adresse symbolique | Adresse IP |
|---|---|---|
| www.google.fr | 172.217.20.163 | |
| YouTube | www.youtube.fr | 142.250.178.142 |
| Leboncoin | www.leboncoin.fr | 18.164.52.43 |
| Amazon | www.amazon.fr | 52.95.116.113 |
Deux cas se présentent. Si le navigateur a déjà traduit ce nom récemment, il garde la réponse dans son cache et n'interroge personne. Chercher www.google.fr peut alors se résumer à réutiliser 172.217.20.163. Si le nom est inconnu, la recherche part de serveur en serveur, jusqu'à celui qui connaît la réponse. On parle de résolution récursive.
Laboratoire du renard
Annuaire du Web
Suis la résolution d'un nom de domaine vers une adresse IP.
HTML, le langage des pages
HTML (HyperText Markup Language) a été créé en 1991 par Tim Berners-Lee, au CERN. C'est un langage à balises : il décrit la structure d'une page, pas son apparence finale.
Une balise est un mot entouré de chevrons, < et >. La plupart s'ouvrent et se ferment. Le navigateur les lit, puis les cache : on voit le paragraphe, pas la balise <p>.
<p>Ceci est un paragraphe.</p>

<h1>Titre principal</h1>
<h2>Sous-titre</h2>

<a href="https://example.com">Lien hypertexte</a>

<img src="image.jpg" alt="Description de l'image" />
Le HTML donne un sens au contenu. Un titre n'est pas « du texte en gros » : c'est un titre. Un lien n'est pas une phrase soulignée : c'est une adresse vers ailleurs. La mise en forme vient ensuite, souvent d'un autre langage.
HTTP, la conversation
HTTP (HyperText Transfer Protocol) est le protocole qui fait circuler les pages sur le Web. Le client envoie une requête. Le serveur répond avec la ressource demandée, et avec un code qui dit si tout s'est bien passé.
Deux méthodes reviennent tout le temps. GET demande une ressource, sans rien modifier sur le serveur : ouvrir une page, charger une image. POST envoie des données, par exemple le contenu d'un formulaire.
Laboratoire du renard
Messager HTTP
Compare les requêtes envoyées par un navigateur.
Le serveur ne répond pas seulement par la page. Il ajoute un code de statut. 200 veut dire que la requête a réussi. 404 veut dire que la ressource n'existe pas, la fameuse page introuvable. 500 veut dire que le serveur lui-même a un problème, indépendamment de la demande.
Pourquoi Google classe les pages comme il le fait
En 1996, Larry Page et Sergey Brin, à Stanford, proposent PageRank. Avant eux, un moteur cherchait surtout les mots de la page. Eux proposent de regarder aussi l'importance de la page dans le réseau des liens.
L'idée est celle d'un vote. Quand une page pose un lien vers une autre, elle vote pour elle. Plus une page reçoit de liens, plus elle semble utile. Mais tous les votes ne pèsent pas le même poids. Un lien depuis une page déjà très citée compte plus que dix liens depuis des pages que personne ne regarde. Au Loup-Garou, le vote du maire compte double : c'est la même intuition.
Ce calcul a aidé Google à proposer des résultats plus pertinents que ses concurrents de l'époque. Les moteurs d'aujourd'hui ont beaucoup ajouté par-dessus, mais l'idée de départ reste celle-là : une page est importante aussi parce que d'autres pages la désignent.
Laboratoire du renard
Classement des terriers
Découvre comment les liens influencent un moteur de recherche.
Ce que les sites retiennent des visiteurs
Définition : cookie Un cookie est un petit fichier texte déposé sur l'ordinateur par un site visité. Il permet de garder une information d'une page à l'autre : un panier, une connexion, une préférence de langue.
Tous les cookies ne servent pas le site consulté. Certains, déposés par des tiers, suivent l'internaute de site en site pour construire un profil publicitaire. C'est pour cela qu'une paire de chaussures poursuit l'internaute après une visite sur un site de sport.
Laboratoire du renard
Boîte à cookies
Distingue les cookies utiles de ceux qui suivent ta navigation.
Le cadenas
En HTTP, les données circulent en clair. Quelqu'un placé sur le chemin, sur le même Wi-Fi par exemple, peut les lire. HTTPS ajoute un chiffrement : le S veut dire secure. Seuls les deux bouts de la conversation peuvent lire le contenu.
Le simulateur ci-dessous montre ce qu'un intermédiaire peut voir selon que le cadenas est là ou non. On appelle ce genre d'écoute une attaque de l'homme du milieu.
Laboratoire du renard
Le tunnel sécurisé
Observe ce que le chiffrement protège pendant le trajet.
Tant que le cadenas n'est pas dans la barre d'adresse, n'écrivez ni mot de passe ni numéro de carte.